规则不是写出来的,是学出来的
机器学习的全部核心思想,其实只有一句话。这一章用一笔网约车订单把它讲透。

这一讲对应《Hello, AI》第 4 章《规则不是写出来的,是学出来的》。主线约 9 分钟的阅读量,展开讲一节课。
本章要回答的问题:机器到底是怎么「学」的?学到的东西存在哪里?
平台要在你上车前报出一个价
一张收费表
起步价多少,每公里多少,夜间加成多少。表是人定的,写进程序,程序按表算。
一个模型
把过去几亿笔订单的距离、时段、天气、供需和成交价喂进去,让模型自己找出「什么样的行程值多少钱」。
用一个学生每周都在用的东西开场。他们大多没想过这两种做法的本质区别。
可以现场问:同样一段路,为什么不同时间的价格不一样?谁定的这个价?答案会自然地引到「没有人定,是学出来的」。
没有人写过
「雨天晚高峰加价 23%」这条规则。
但模型的行为里包含了它,而且比人写的更细。
这一章只做一件事:把「让模型自己找规律」拆开,看清每一个零件。
这些零件在后面的神经网络和大语言模型里一个都不会少,只是尺寸变大了。
请强调最后一句。学生常以为大模型是另一种东西,其实它用的还是这一章的五个零件:样本、特征、参数、损失、梯度下降。
机器到底是怎么「学」的?
学到的东西存在哪里?
样本、特征、标签
一台带旋钮的机器
错了多少,怎么改
第二个问题(学到的东西存在哪里)会在本章中段得到一个具体得让人不安的答案:存在几千亿个数字里,人读不懂。
一句话的范式转变
传统编程和机器学习的区别,不在语言、不在算力,而在「规则」这个东西站在等号的哪一边。
规则从输入变成了输出
传统编程:规则 + 数据 → 答案
人写出规则,程序把输入按规则变成输出。规则是人提供的。
机器学习:数据 + 答案 → 规则
人提供大量的例子,机器找出把前者变成后者的规则。规则是学习产生的。
这两行可以写在黑板上,整节课都不要擦。本章后面每一个零件,都是在解释第二行怎么实现。
当规则难写,而例子好找
- 你说不清一张照片里「猫」的判据是什么但你能轻松标出一万张有猫的照片。
- 你说不清一笔行程该值多少钱但你有一亿笔已经成交的行程。
专家系统的瓶颈是知识获取:专家自己也说不清他怎么判断的。机器学习绕开了这个问题——不问你怎么判断,只要你给例子。
「规则难写而例子好找」是判断一个问题该不该用机器学习的第一条标准。反过来,规则清楚好写的地方(发票计算、排班约束),别用模型。
学出来的规则不是 if-then,
而是几千到几千亿个数字。
人读不懂它,只能测试它。
这是机器学习「黑箱」性质的根源。后面每一章都会撞上它:
第五章的评估、第十章的幻觉、第十四章的责任,都是在处理这一句话的后果。
请把这一页讲得慢一点。学生需要在第一次接触机器学习时就建立这个认识:可解释性不是没做好,是这条路本身的代价。
三个零件:数据、模型、目标
任何机器学习系统都由这三部分组成,从一条直线到万亿参数的大模型,一个不多,一个不少。
它是一行数字
这一整行
一亿行排成一张大表,就是训练数据。
每一个数字
模型能看到的、关于这笔订单的一切。
最后那个数
我们希望模型学会预测的答案。
这三个词是整门课的基础词汇,务必让学生能用自己的例子复述一遍:一张病历里,什么是样本、什么是特征、什么是标签?
把现实变成这张表
| 特征 | 怎么算 | 为什么要它 / 陷阱 |
|---|---|---|
| 路程距离 | 路网最短路(不是直线) | 最重要的特征;用直线距离会低估跨江订单 |
| 出发时刻 | 拆成「小时」和「是否工作日」 | 直接用时间戳没意义,模型需要周期性 |
| 距高峰的分钟数 | 与最近早晚高峰的时间差 | 比「小时」更贴近真实的供需变化 |
| 天气 | 降雨量、温度 | 用的是下单时的天气,不是行程结束时的 |
| 起点供需比 | 附近 2 公里空车数 ÷ 等待订单数 | 溢价的核心;训练时必须用「当时」的快照 |
| 乘客历史订单数 | 用户过去的下单数 | 用于定价时要小心公平性问题 |
| 当前活动 | 演唱会、赛事散场 | 很难自动获得,常靠人工维护的日历 |
不必逐行念。挑两行讲:「出发时刻要拆开」说明模型看不懂人类的表示方式;「当前活动靠人工维护」说明模型再好也需要人补它看不到的世界。
这一步做得好坏,影响巨大
很多特征是「翻译」
把时间戳拆成周期,把类别编码成数字。对传统机器学习模型来说,翻译得好不好几乎决定成败。
时间陷阱
必须只用「下单那一刻能知道的信息」。用事后才知道的信息,就是第五章的标签泄漏。
有些事它交不出去
深度学习把很多手工判断交给了网络,但「用什么时刻的数据」这类问题,交不出去。
在深度学习之前,工程师大部分时间花在特征工程上。第六章会讲深度学习最大的贡献之一,就是把这一步也交给机器——但第二、三条仍然是人的责任。
学习,就是找到旋钮的位置
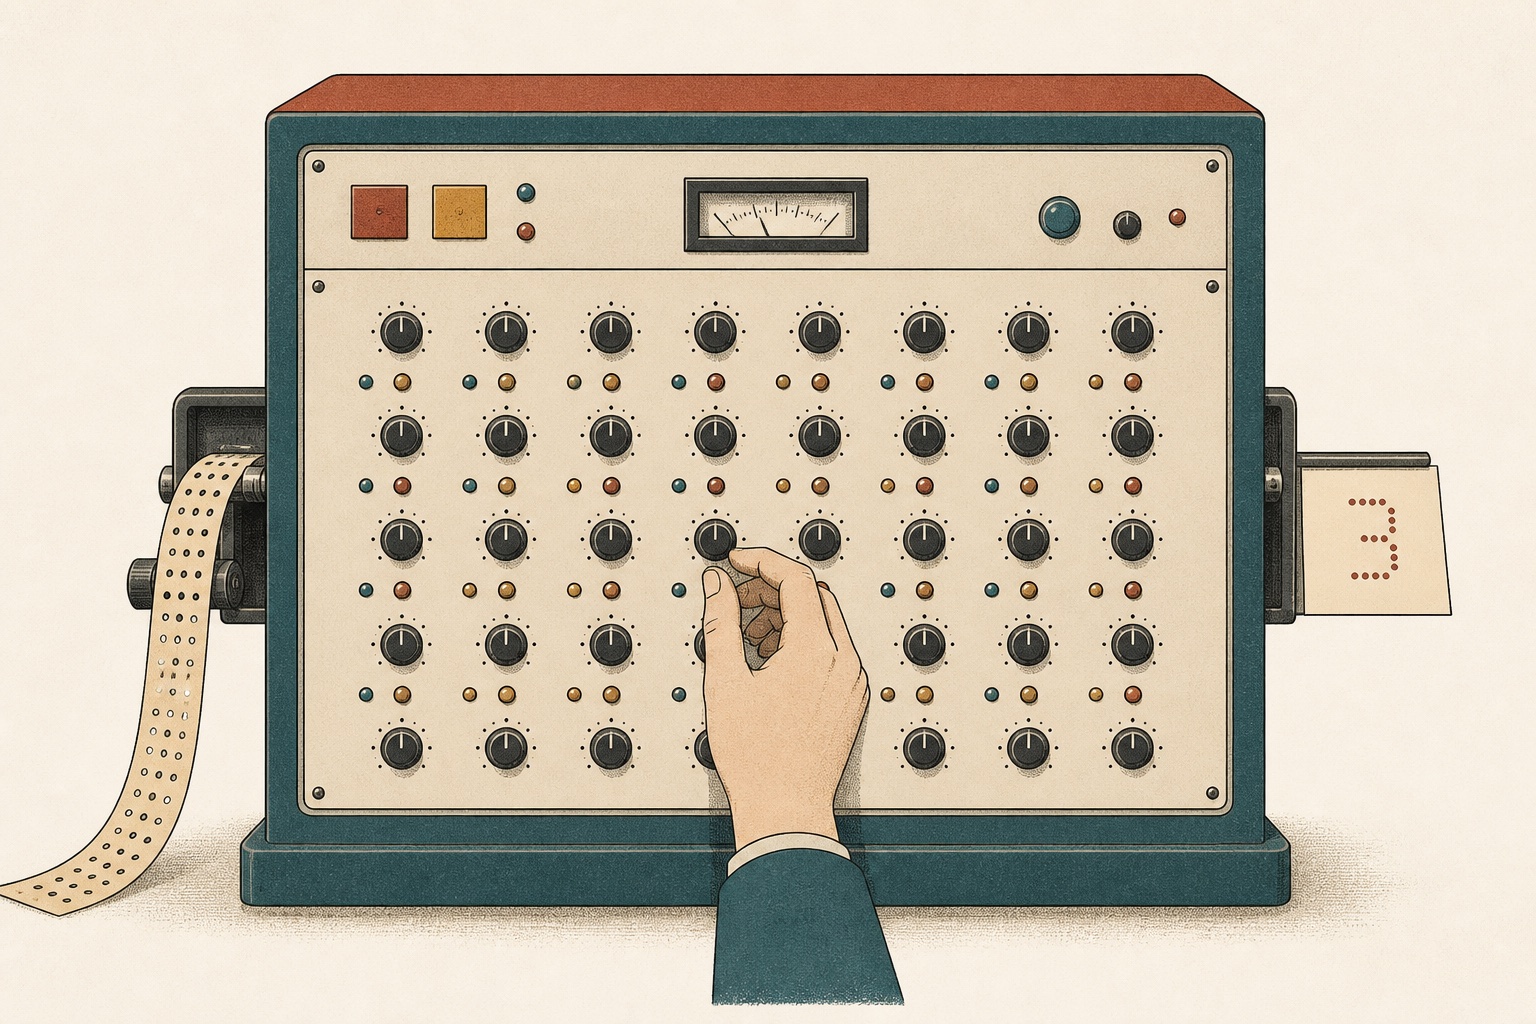
「旋钮」这个比喻贯穿全书。第六章的神经网络、第七章的词向量、第九章的微调,说的都是同一件事:把旋钮拧到哪里。
从三个到几千亿
价格 = w₁ × 距离 + w₂ × 时长 + b
这就是最简单的模型:一条直线,三个旋钮。术语叫参数。
一条直线能表达的规律很有限。多项式可以弯曲,决策树可以分段,神经网络可以有几十亿个旋钮。
- 越复杂,能表达的规律越丰富
- 也越容易学到不该学的东西第五章的主角:过拟合。
这里埋下第五章的钩子。可以先给一句话的剧透:一个旋钮足够多的模型,可以把训练数据背下来,却在新数据上一塌糊涂。
错了多少?怎么改?
损失函数
对车费预测,最自然的损失是预测价与真实价之差的平方,在所有样本上求平均。损失越小,模型越准。
它把「好不好」这个模糊的评价,变成一个可以计算、可以比较的数。
梯度下降
对每一个旋钮,算「往右拧一点,损失会增大还是减小」,然后往减小的方向拧一小步。
对所有旋钮同时做,重复几千几万次,损失就一路下降。
请点明:这两个问题的答案,就是「训练」的全部内容。学生以后听到「训练了三个月」,脑子里应该是这两件事重复了无数次。
「错」可以有不同的算法
差的平方的平均
对大错误惩罚极重(差 10 元是差 1 元的一百倍)。数学上最好处理。
缺点:对异常值敏感,一笔录入错误的天价订单能把整个模型拉偏。
差的绝对值的平均
对每一元的错误一视同仁,对异常值稳健。
数据里有脏值、或你关心「典型情况下差多少」时更合适。
分类任务的标准损失
衡量「真实类别被分到的概率有多小」。惩罚自信地错远超犹豫地错。
大语言模型预训练用的就是它:每一步预测下一个 token。
一条经验:先问「什么样的错误最贵」,再选那个对这种错误惩罚最重的函数。这是把业务判断写进数学的地方。
最后这句话值得讲透:选损失函数不是技术决定,是价值判断。漏诊和误诊哪个更不可接受?这个问题应该由懂业务的人参与回答。
蒙着眼睛下山

补一句:它不保证到达最低的谷底,但在实践中出奇地有效——而且它就是训练万亿参数大模型时用的那个算法,一个字都没变。
沿着损失下降的方向,一小步一小步走
- 不必用全部数据随机抽一小批估计梯度就够了,这叫随机梯度下降;噪声还能帮模型跳出浅坑。
- 几十亿个梯度能一次算完靠一种叫反向传播的方法,第六章讲。
现场演示曲线拟合实验:拖几个点,看曲线一步步贴近,右边损失曲线往下走。再把多项式次数调很高——曲线穿过每个点却疯狂扭动,那就是第五章的过拟合。
学习率:步子迈多大
下山慢得像蜗牛
方向对,但要走很久。算力全花在路上。
稳步下降
损失曲线平滑地往下走。这是训练时最想看到的画面。
在山谷两侧来回跳
甚至越跳越高,损失直接发散。
更新规则就一行:w ← w − η · ∇L(w)。减号表示往下坡走,η 就是学习率。调学习率是训练里最常见的手工活。
学生会问「那怎么知道该取多少」。诚实的答案是:试。现在有自动调节的办法,但本质仍是经验加试错。
两个旋钮,三笔订单
车费 = w · 距离 + b
w 是每公里单价,b 是起步价。手里有三笔订单:
| 距离(公里) | 实际车费(元) |
|---|---|
| 2 | 14 |
| 5 | 23 |
| 10 | 38 |
- w = 1,b = 0三笔预测分别是 2、5、10,差得很远。
- 损失 ≈ 417均方误差:(144 + 324 + 784) ÷ 3。
这一页和下一页可以在黑板上边讲边算。学生亲眼看到数字从 417 掉到 50,比任何比喻都有说服力。
从 417 到 50,再到「每公里三元,起步八元」
- 算梯度∂L/∂w ≈ −263,∂L/∂b ≈ −39。都是负的,意思是「把旋钮往大调,损失会下降」。
- 更新(学习率 0.01)w ← 1 − 0.01 × (−263) = 3.63;b ← 0 − 0.01 × (−39) = 0.39。
- 再算损失已经降到 50 左右。一步。
- 重复几百次w 收敛到 3 附近,b 到 8 附近:每公里三元,起步八元。
没有人告诉模型这两个数字,它们是从三笔订单里「学」出来的。
这就是本章标题的字面演示:规则(每公里三元)不是写出来的,是学出来的。
真实模型和这个例子的区别,
只有规模。
旋钮从两个变成几千亿个,样本从三笔变成几万亿个 token。
其余的每一步都一样:算梯度,走一小步,重复。
安心的是:你已经理解了训练大模型的全部原理。不安的是:我们对这个过程的理解,也就到这个程度——规模变大后发生了什么,至今没有完整的理论。
在表格数据上,至今赢家常常是树
一连串问题
「距离大于 10 公里吗?是的话,是高峰期吗?是的话,约 45 元。」贪心地选最能分开数据的问题。
优点:人能读懂。缺点:容易长到把每个样本单独分出来。
几百棵树投票
每棵只看一部分数据和一部分特征,最后投票。单棵树的过拟合被平均掉了。
一棵接一棵地补错
每棵专门修正前面所有树的错误。名字里有「梯度」,但树本身不是梯度下降训练的。
实用建议:在表格数据(订单、病历、学生记录)上,先跑一个梯度提升树作为基线,再考虑别的。几万行的表格不足以喂饱一个深度网络。
这一页很实用。很多学校和医院的数据规模,正好是「树比神经网络更合适」的那一档。别让学生以为深度学习总是更好。
四种学习方式
按「答案从哪里来」,机器学习分成几个范式。第四种是过去十年最重要的新东西,也是大语言模型的根基。
监督、无监督、强化、自监督
数据带标签
历史订单有成交价,照片有人标了「猫」,邮件被标过「垃圾」。模型学习从特征到标签的映射。
最成熟、应用最广。瓶颈是标签贵。
没有标签,只找结构
把一亿个乘客按出行习惯自动分群,把新闻按主题归类,在交易记录里找「和别的都不像」的异常。
它不告诉你每一群是什么,只告诉你数据里有这样的分野。
只有行动之后的奖励
第三章讲过。学的不是「这个输入对应什么输出」,而是「这种情况下该做什么」。
从数据本身制造标签
把一句话遮住一个词让模型猜;把一段文字截断让模型续写。标签藏在数据里,不需要人标。
所以可以用整个互联网来训练。第七章开始讲它怎么造出语言模型。
四张卡片里,请把自监督讲得重一些。它是「数据可以无限」这件事的技术原因,也是 2020 年之后一切的前提。
每一个标签背后都是人的时间
- 自动驾驶雇大量标注员逐帧框出行人和车辆。
- 病理切片需要病理医生逐张标注肿瘤边界。
标签不但贵,还会带进标注者的偏见和错误。
- 半监督少量标注 + 大量未标注,用粗模型打「伪标签」。
- 主动学习模型自己挑最不确定的样本请人标。
- 迁移学习大数据集上训好,换任务只需少量微调。深度学习时代的默认做法。
- 自监督彻底不要人工标签。
迁移学习这一条是今天绝大多数应用的实际形态:没有人从零训练模型,都是拿别人训好的来微调。第九章会再讲。
「我们的模型准确率 98%」
——标签是谁标的,怎么标的?
模型学到的上限,是标签的质量。
标签错了,模型会把错误学得非常好。
这句话学生带出教室就能用。以后看任何 AI 产品的宣传数字,先问标签从哪来。
一个连「训练」都没有的模型
它只是记住所有样本。来了新的点,就看离它最近的 K 个邻居多数是什么。
没有旋钮,没有损失函数,没有梯度下降。但它确实在做分类,而且在小数据上常常不差。
- K 调小决策边界碎得像地图上的飞地——它在迁就每一个噪声点。
- K 调大边界变粗变钝,细节被抹平。
「太碎」和「太粗」就是第五章过拟合与欠拟合的视觉版本。这个实验是第五章最好的预热,值得当堂做一遍。
一个完整的项目
把零件装起来。你会发现,真正花时间的地方,和你以为的不一样。
一个机器学习项目长这样
- 定义任务预测什么?用什么指标衡量好坏?错了的代价是什么?
- 收集数据哪些历史记录可用?它们能代表未来吗?有没有偏差?
- 构造特征把原始记录变成模型能用的数字。
- 划分数据一部分训练,一部分留着最后考试。这一步是第五章的主角。
- 训练选模型,跑梯度下降,看损失下降。
- 评估在留出的数据上考试,看指标。
- 部署与监控上线,然后盯着它,因为世界会变。
请学生猜哪一步最花时间。绝大多数人会猜第五步(训练)。答案在下一页。
最后一步会把你送回第二步
这张图把本章前后两半缝在一起:上半是范式翻转,下半是工程流程。
第一步和第二步花的时间,
通常远超第五步。
「用什么模型」往往是最不重要的决定;
「预测的是不是对的东西」和「数据里有没有陷阱」才是。
这句话对准备做项目的学生特别重要。选模型是最容易的一步,也是最容易被误认为核心的一步。
每一步会撞到什么(上)
一所高中想在期中前找出「期末可能不及格」的学生,提前干预。
- 1 定义任务先问:预测出来之后做什么?让班主任多谈一次话,误报代价很低;把学生分到「补差班」,误报就是伤害一个原本正常的孩子。这个答案决定后面的一切。
- 2 收集数据三年前教材和考试方式变了;去年这个年级换了老师;平台前年才上线,更早的登录记录是空的。
- 3 构造特征「是否参加补习班」只在期末后由老师补录——用它就是标签泄漏。
第一步那个追问是整页的灵魂:同一个模型,用途不同,可接受的错误率完全不同。技术指标不能脱离用途来谈。
每一步会撞到什么(下)
- 4 划分数据按学年切:前两年训练,最近一年测试。不能随机打乱,否则模型会「偷看」同一学年的同学。
- 5 训练一个梯度提升树,二十分钟。这是整个项目最轻松的一步。
- 6 评估准确率 91%。但不及格率只有 12%——要看召回率:只找出了 55%,漏掉近一半;标出的学生里有三成实际及格。能用,但要当作提示而不是判决。
- 7 部署与监控上线一个学期,召回率降到 40%。原因:学校换了作业平台,「提交率」这个特征的含义变了。回到第二步。
没有任何一步是技术难题,每一步都是判断。机器学习把规则交给了机器,却把更多的判断留给了人。
第六步的数字请讲透:91% 的准确率听起来很好,但在 12% 的不及格率下,一个「全部预测及格」的傻模型准确率也有 88%。第五章会正面处理这件事。
机器学习的语法是通用的
| 领域 | 样本 | 特征 | 标签 |
|---|---|---|---|
| 网约车定价 | 一笔订单 | 距离、时段、天气、供需 | 成交价 |
| 学情预警 | 一个学生一学期 | 出勤、作业提交、测验分、在线时长 | 期末是否及格 |
| 临床预测 | 一次住院 | 检查数据、用药、病史 | 三十天内是否再入院 |
| 文本分类 | 一篇文章 | 词频 / 向量表示 | 它的主题 |
请学生现场填一行:他自己专业里的一个问题,样本、特征、标签分别是什么。能填出来,这一章就算学会了。
三个问题,一个都不能省
数据从哪来?
它能不能代表要预测的对象?在城里收的数据,能用在郊县吗?
标签是什么?
它真的是我们关心的那个东西吗?「期末及格」等于「学得好」吗?
错了的代价由谁承担?
老师多关注他,是好事;系统把他分到差班,是另一回事。
第二个问题最容易被跳过,也最致命:我们往往优化的是「能测量的那个东西」,而不是真正关心的东西。第五章、第十四章都会回到这里。
用数据和答案,
让一台带旋钮的机器
通过不断减小损失,自己找到规则。
规则藏在旋钮的位置里。人读不懂,但可以测试。
下一章就讲怎么测试——以及为什么「在训练数据上表现很好」几乎什么都不说明。
这句话是本章的全部。如果学生只记住一句,就是这一句。最后一行是第五章的引子。
「传统编程把规则当输入,机器学习把规则当输出。」用网约车的例子解释这句话。
损失函数和评估指标有什么区别?
二、损失函数是训练时用来指导旋钮往哪拧的数学量,必须可导、可计算,比如均方误差。评估指标是我们真正关心的业务量,比如「预测价与实际价相差 10% 以内的比例」。两者常常不同:训练优化的是前者,最后汇报的是后者。
先让学生回答,再按右键展开答案。第二题是很多人的盲区,也是第五章的入口。
自监督学习为什么能用「整个互联网」训练,而监督学习不能?
可以补一句:这也解释了为什么「数据用完了」会成为一个真问题——当标注不再是瓶颈,文本总量就成了瓶颈。
一个学情预警模型准确率 90%,老师该怎么用它?
最后一句会让学生吃一惊,这正是第五章要展开的第一个话题。可以把它作为下节课的开场。
这一章留下什么
- 范式翻转:传统编程是「规则 + 数据 → 答案」,机器学习是「数据 + 答案 → 规则」。代价是规则变成了人读不懂的数字。
- 三个零件:数据(样本、特征、标签)、模型(带旋钮的机器)、目标(损失函数 + 梯度下降)。大模型也只有这三个,只是尺寸变大。
- 梯度下降就是蒙眼下山:算梯度,往下走一小步,重复。训练万亿参数用的是同一个算法。
- 四种范式按「答案从哪来」划分;自监督从数据自身造标签,这是大语言模型能用整个互联网训练的原因。
- 项目里最花时间的是第一、二步:预测的是不是对的东西,数据里有没有陷阱。选模型往往是最不重要的决定。
继续读
正文与「深入」段落:ai4edu.sjtu.edu.cn/helloai/read/learning-from-data/
下一章:第 5 章 真正的考试在训练集之外
留三到五分钟做本页的回顾,让学生用自己的话复述其中一条。